Blogger kullanıcıları neden buna ihtiyaç duyar?
Her Blogger blogu aynı robots.txt dosyasıyla başlar. Bu dosya AdSense tarayıcısının her şeyi görmesine izin verir, diğer tüm botlar için /search yolunu engeller ve sitemap'i bildirir. Etiket sayfaları ve arama sonuçları da bu yolun altındadır. Blogların çoğu bundan fazlasına ihtiyaç duymaz; dosyayı değiştirenlerin birçoğu da olduğu gibi bıraksa daha iyi ederdi.
Sorun Ayarlar → Tarayıcılar ve dizine ekleme bölümünde başlar. "Özel robots.txt'yi etkinleştir" seçeneğini açtığınızda yapıştırdığınız metin Blogger'ın dosyasının tamamen yerine geçer. Varsayılandan geri kopyalamadığınız hiçbir satır kalmaz. Eğitim yazılarında dolaşan sürümler /20 arşivlerini, ?m=1 mobil görünümünü ya da bütün klasörleri engeller. Tek bir yanlış satır Google'ın hiçbir yazıyı taramamasına yol açabilir. Blogger sizi uyarmaz; Search Console da sorunu ancak Googlebot denedikten sonra raporlar.
Bu araç canlı dosyanızı çeker, Googlebot, Googlebot-Image ve Bingbot'un hangi gruba uyduğunu bulur ve verdiğiniz her URL'yi kontrol eder. Sonuç izinli ya da engellidir; kararı veren satır ve satır numarası da yanında yazar. Böylece neyi değiştirmeniz gerektiğini tahmin etmek zorunda kalmazsınız.
Blogger kullanıcıları için rehber
Blogger kullanıcıları için özel ipuçları
Yalnızca dosyayı değil, URL'leri test edin. Ana alana bir yazı URL'si yazın; yollar kutusuna bir etiket sayfası, bir arama URL'si, bir sabit sayfa (/p/…) ve yazının ?m=1 sürümünü ekleyin. Varsayılan dosyada yazılar, sayfalar ve ?m=1 izinlidir; yalnızca /search URL'leri engellenir. /2026/… ya da /p/ altındaki bir URL Engelli görünüyorsa Belirleyen kural sütunu silmeniz gereken satırı gösterir. Aynı tabloda her botun hangi User-agent grubunu kullandığını da görürsünüz.
robots.txt'ye dokunmadan önce etiket sayfalarının nerede duracağına karar verin. İki temiz kurulum vardır. Birincisinde Disallow: /search kalır ve Google etiket sayfalarını hiç taramaz. İkincisinde bu sayfalara izin verir, özel robot üstbilgi etiketleriyle arşiv ve arama sayfalarına noindex verirsiniz. Böylece Google bu sayfaları tarar, yazılarınıza giden bağlantıları izler ve sayfaları sonuçlara almaz. İkisini karıştırmak işe yaramaz: engellenmiş bir URL'nin noindex etiketi hiç okunmaz ve URL yine "Dizine eklendi, ancak robots.txt tarafından engellendi" olarak görünebilir. Hangisini seçerseniz seçin, ardından bir etiket URL'sini burada çalıştırıp dosyanın istediğinizi söylediğini doğrulayın.
Sitemap satırını kontrol edin. Özel alan adında bu satır okurların gördüğü adresi, genellikle www adresini kullanmalıdır; Blogger çıplak alan adında blog barındırmaz, yalnızca yönlendirir. Dosyayı kendiniz yazdıysanız içinde hâlâ bir Sitemap satırı olduğundan emin olun. Dosyanın geri kalanı düzgün göründüğü için eksik satır kolayca gözden kaçar.
Yaygın hatalar
Pahalıya patlayan hata, bir eğitim yazısındaki "Blogger için en iyi robots.txt" metnini test etmeden yapıştırmaktır. Kaydetmeden önce yazı, etiket ve sayfa URL'lerinizi mevcut dosyaya karşı burada çalıştırın. Kaydettikten sonra aynı URL'leri yeniden çalıştırın; Blogger yeni dosyayı hemen sunar. Bir şey ters giderse varsayılan metni geri yapıştırmak ya da özel robots.txt seçeneğini kapatmak dosyayı ilk hâline döndürür.
Hızlı başlangıç
- Blogunuzdan bir yazı URL'si girin.
- Bir etiket sayfası, bir
/p/sayfası ve yazının?m=1sürümünü ekleyin. - Her yazı ve sayfa Googlebot için İzinli görünmeli.
- Sitemap satırının gerçek adresinizi kullandığını kontrol edin.
- Tarayıcılar ve dizine ekleme ayarındaki her değişiklikten sonra aynı URL'leri yeniden test edin.
Gerçek örnekler
1. Blogger'ın varsayılan dosyası: yazılar açık, etiket sayfaları kapalı
- Durum
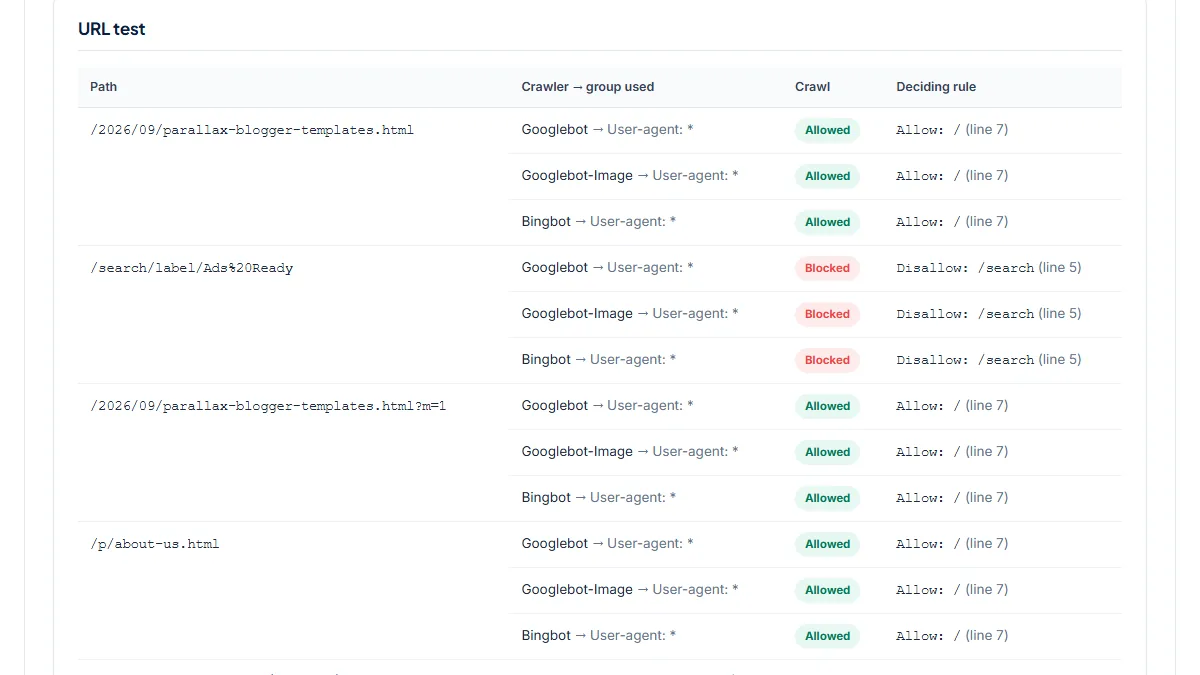
- Sora Templates, Blogger temalarını özel alan adlı bir Blogger blogundan satıyor ve hiç dokunulmamış varsayılan robots.txt dosyasını sunuyor. 25 Ekim 2026'da Eylül 2026 tarihli bir yazıyı, bir etiket sayfasını, yazının mobil görünümünü ve Hakkımızda sayfasını test ettik.
- Girdi
https://www.soratemplates.com/2026/09/parallax-blogger-templates.html, yollar/search/label/Ads%20Ready,…templates.html?m=1,/p/about-us.html- Sonucu yorumlama
- İki grup var: boş Disallow satırıyla
Mediapartners-Google(AdSense tarayıcısı her şeyi çekebilir) veDisallow: /search,Disallow: /share-widget,Allow: /satırlarıyla*. Googlebot, Googlebot-Image ve Bingbot'un üçü de*grubuna düşer. Yazı,?m=1sürümü ve Hakkımızda sayfasıAllow: /(7. satır) ile İzinli; etiket sayfasıDisallow: /search(5. satır) ile Engelli. Bu başlangıç noktasıdır: özel dosyanız bundan fazlasını engelliyorsa nedenini bilmelisiniz.
2. Özel dosya /search yolunu açıyor, noindex sonuçlardan uzak tutuyor
- Durum
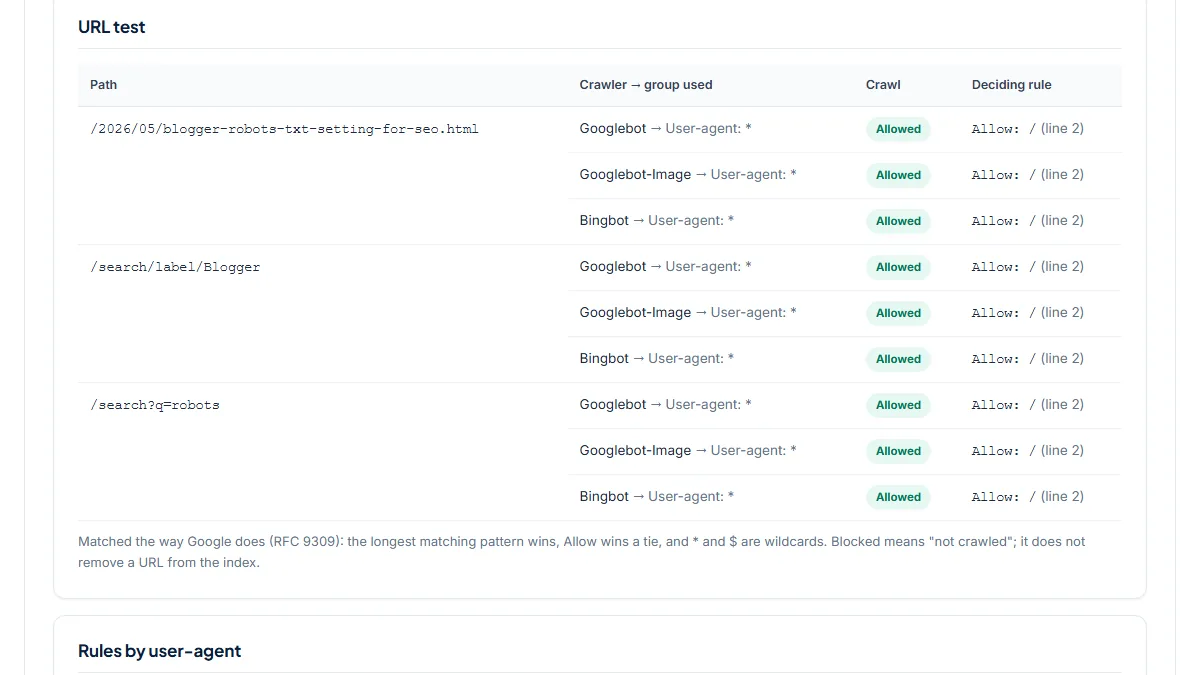
- Sahil Dubey'nin blogu özel alan adıyla Blogger'da çalışıyor; özel robots.txt dosyası sitemap'ler dışında yalnızca iki satır. Bloğun bir yazısını, bir etiket sayfasını ve bir arama URL'sini test ettik, sonra bu iki sayfanın robots meta etiketlerini okuduk.
- Girdi
https://www.sahildubey.com/2026/05/blogger-robots-txt-setting-for-seo.html, yollar/search/label/Blogger,/search?q=robots- Sonucu yorumlama
- Tek grup var: yalnızca
Allow: /içerenUser-agent: *. Bu yüzden üç URL de İzinli (2. satır) ve hiç Disallow kuralı kalmamış; varsayılandaki/searchengeli gitmiş. İki sitemap bildirilmiş:/sitemap.xmlve en fazla 500 yazılık biratom.xmlbeslemesi. Etiket ve arama sayfalarının ikisi denoindex, followrobots meta etiketi sunuyor. Google bu sayfaları tarayıp yazılara giden bağlantıları izleyebiliyor, noindex ise sayfaları sonuçlardan uzak tutuyor. Engellemenin tutarlı alternatifi budur.
3. Daha dar bir kural: arama sonuçları engelli, etiket sayfaları dizine açık
- Durum
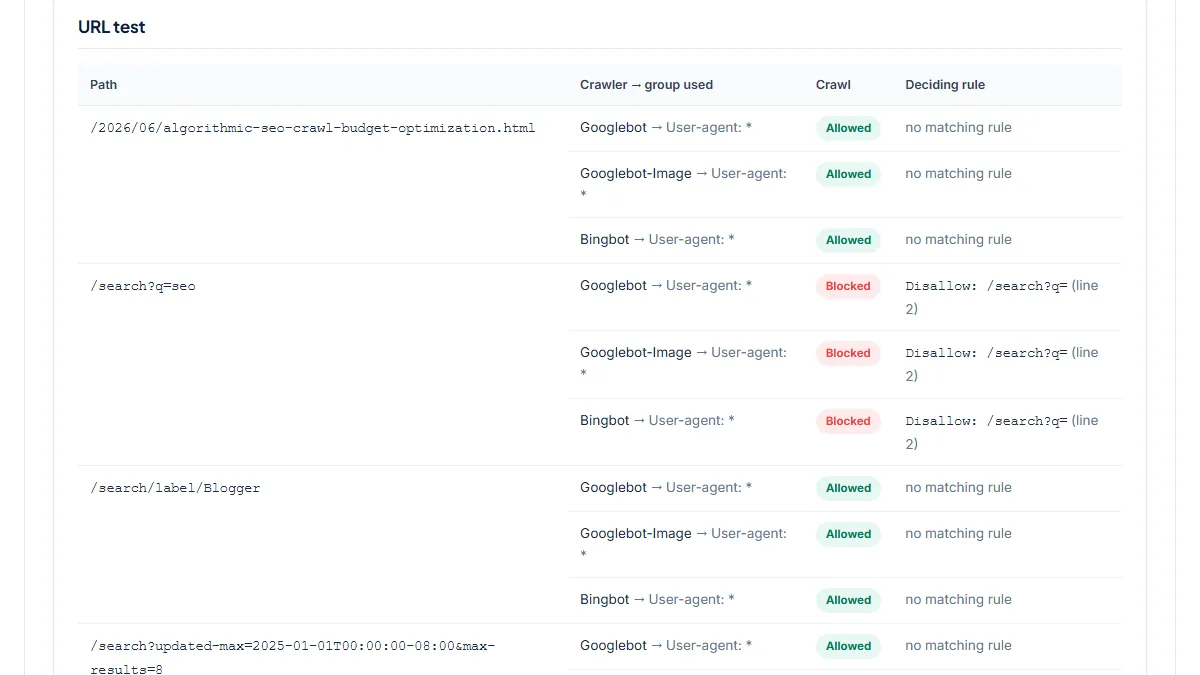
- Blog yazarlığı üzerine bir Blogger blogu olan BloggerSpice, varsayılan dosyanın yerine tek bir kural koymuş. Haziran 2026 tarihli bir yazıyı, bir aramayı, bir etiket sayfasını ve bir "Önceki yayınlar" sayfalama URL'sini test ettik.
- Girdi
https://www.bloggerspice.com/2026/06/algorithmic-seo-crawl-budget-optimization.html, yollar/search?q=seo,/search/label/Blogger,/search?updated-max=…&max-results=8- Sonucu yorumlama
- Tek grup ve
Disallow: /search?q=kuralı var. Yalnızca arama sonucu Engelli; yazı, etiket sayfası ve sayfalama URL'si eşleşen kural olmadan İzinli. Etiket sayfasının kendisi deindex, followsunuyor. Bu, etiket sayfalarının sıralamaya girmesi için bilinçli bir tercih ve herupdated-maxsayfasını da taramaya açıyor. Sitemap satırıbloggerspice.comadresini gösteriyor, blog isewwwüzerinde. Blogger çıplak alan adını yönlendiriyor, amawwwURL'sini yazmak tarayıcıları fazladan bir adımdan kurtarır.
Sık yapılan hatalar
- Bir eğitim yazısındaki özel robots.txt'yi kendi yazı URL'lerinizi test etmeden yapıştırmak.
Disallow: /20ya daDisallow: /*.htmlgibi kurallar zararsız görünür ama her yazıyı engelleyebilir. - Kendi dosyanızı yazarken Sitemap satırını unutmak. Özel metin varsayılanın tamamen yerine geçtiği için sitemap bildirimi de onunla birlikte kaybolur.
- Etiket ya da arama sayfalarını robots.txt ile engelleyip bir de noindex vermek. Google engellenmiş sayfayı hiç çekmez, bu yüzden noindex etiketini de hiç okumaz.
- Google'dan kaldırmak istediğiniz bir yazıyı robots.txt ile gizlemeye çalışmak. Engelleme taramayı durdurur, dizine eklemeyi değil; bunun yerine yazının kendi "noindex" özel robot etiketini açın.
- WordPress için yazılmış,
Disallow: /wp-admin/ya da/feed/gibi satırlar içeren bir dosyayı kopyalamak. Bu yollar Blogger'da yoktur; /search kararı gibi gerçekten gereken kurallar ise dosyada eksik kalır.
Sık sorulan sorular
Search Console etiket sayfalarım için "robots.txt tarafından engellendi" diyor. Bu bir sorun mu?
Varsayılan ayarlarda değil. Blogger'ın kendi robots.txt dosyası /search yolunu engeller ve etiket sayfaları /search/label/ altında durur. Yani bu durum dosyanın işini yaptığını gösterir. Önemli olan yazılarınızdır: birini burada çalıştırın, İzinli görünmelidir. Yalnızca etiket sayfalarını Google'da görmek istiyorsanız harekete geçin. O zaman /search engelini kaldırın ve dizine eklenip eklenmeyeceklerine özel robot üstbilgi etiketleriyle karar verin.
Blogger'da özel robots.txt'yi açmalı mıyım?
Yalnızca varsayılanın karşılamadığı bir nedeniniz varsa. Varsayılan dosya yazılara ve sayfalara zaten izin verir, arama ve etiket sayfalarını engeller ve sitemap'inizi bildirir. Blogger Yardım'a göre özel metin varsayılanın yerine kullanılır; yani her satırın sorumluluğu size geçer. Açacaksanız varsayılan metinden başlayın, her seferinde tek bir satırı değiştirin ve her kayıttan sonra yazı URL'lerinizi burada test edin.
Yeni yazılarım dizine eklenmiyor. Neden robots.txt olabilir?
Olabilir ve ilk elenmesi gereken neden de budur, çünkü kontrolü en hızlısıdır. Yeni bir yazının URL'sini burada çalıştırın: Googlebot için İzinli görünüyorsa robots.txt onu engellemiyor demektir. Sonra başka yerlere bakın: yazının özel robot etiketleri, Search Console'daki Sayfa dizine ekleme raporu ve URL Denetimi, bir de Tarama İstatistikleri. Özel alan adlı Blogger kullanıcıları daha önce de yavaş dizine eklemeden şikâyet etti; Google'dan John Mueller onlara Tarama İstatistikleri'ni gösterdi.
?m=1 mobil URL'si için ayrı bir kural gerekir mi?
Hayır. Blogger mobil görünüm için ?m=1 ekler. Yazı sayfasındaki canonical etiketi parametresiz URL'yi gösterir, bu yüzden Google ikisini tek sayfa olarak birleştirir. ?m=1 sürümünü robots.txt ile engellemek yalnızca bu canonical etiketini Googlebot'tan saklar. Varsayılan dosyada parametreli sürüm izinlidir. Özel dosyanızın da onu aynı şekilde ele aldığını görmek için kendi yazınızla burada test edin.
robots.txt dosyamdaki Mediapartners-Google grubu nedir?
Bu, AdSense tarayıcısıdır. Blogger'ın varsayılan dosyası ona boş bir Disallow satırı verir; yani her sayfayı çekebilir. Böylece reklamlar, diğer botların uzak tutulduğu sayfalarda bile içeriğinizle eşleşebilir. Bu grup ayrıdır: aramadan sorumlu Googlebot onu kullanmaz, * grubuna uyar. Özel bir dosya yazıyorsanız ve blogunuzda AdSense reklamı gösteriyorsanız bu grubu dosyanızda mutlaka tutun.
Kaynak: Blogger Yardım'daki blog ayarları rehberi, özel robots.txt içeriğinin arama motorlarına sunulan varsayılan dosyanın yerine kullanıldığını ve blogların çıplak alan adlarında barındırılamayacağını belirtir.